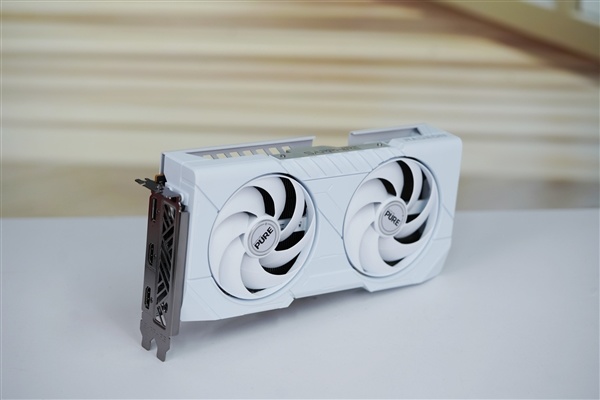
快科技9月15日消息,獨立開發者Speedstu近日開源了名為「CUDA-for-AMD-Windows」的項目,在Windows上實現了AMD顯卡運行CUDA專屬工作負載,無需藉助虛擬機或雙系統。
實測環節該項目在RX 9060 XT上成功訓練了一個220萬參數的PPO強化學習網絡,全程使用未經修改的CUDA庫。
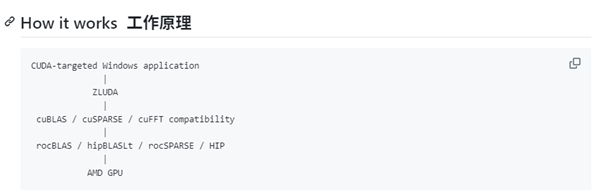
這個項目是一套高度自動化的PowerShell腳本,將ZLUDA翻譯層與AMD原生的HIP/ROCm SDK for Windows對接。
腳本會自動檢測GPU架構,拉取特定版本的ZLUDA(v6-preview.69),映射到Windows上已有的ROCm數學庫。開發者成功攔截並映射了CUDA驅動API以及cuBLAS、cuSPARSE、cuFFT三個核心庫,直接轉接到AMD的等效實現上。
AMD近期通過ROCm更新為Windows消費級GPU帶來了正式的PyTorch和HIP SDK支持,RX 7000和RX 9000系列全面覆蓋。
但大量專有應用、老舊代碼庫和專用AI工具仍然只認CUDA,AMD用戶想跑這些工具只能靠WSL2穿透或等原作者寫HIP移植版,這個項目就是填這個空,相當於給只認NVIDIA的軟件裝了一個轉接頭。
基準測試顯示,在RX 9060 XT上跑220萬參數強化學習工作負載,走官方ZLUDA加AMD HIP SDK 6.4的路徑,吞吐量中位數13278 steps/秒;走從舊版ZLUDA二進制文件中 salvaged 出來的自定義覆蓋層,12876 steps/秒,慢約3%。
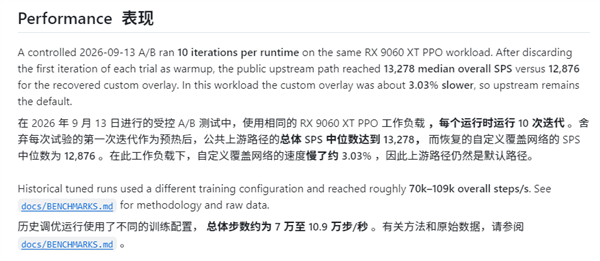
開發者也坦言,後續重寫去掉LibTorch/ZLUDA後吞吐量大幅提升,說明這層翻譯棧仍有性能損耗。
不過現在還遠不到CUDA護城河被填平的時候,關鍵AI庫cuDNN、TensorRT和NCCL目前均無法解析,如果工具重度依賴cuDNN,這套方案就會直接失效。
但這個項目證明了一件事:在AMD顯卡上跑CUDA專屬軟件的障礙不是硬件層面的硬傷,而是可以解決的翻譯工具問題,項目完全開源,社區貢獻有望擴展更多硬件支持和CUDA庫兼容。